格物
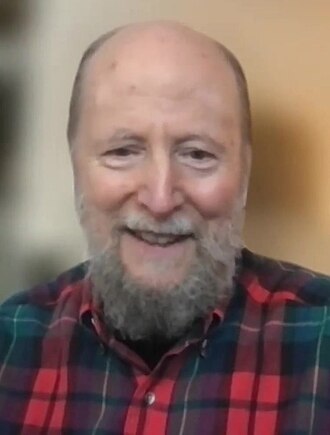
图:Numenta · CC BY 3.0 · Wikimedia Commons
- 出生
- 20 世纪,俄亥俄州
- 国籍
- 加拿大
- 学科
- 计算机科学、工程与发明、博物与综合
- 职业
- 计算机科学家、工程师、人工智能研究者、大学教师
- 母语 / 工作语言
- 英语
- 母校
- 马萨诸塞州立大学艾莫斯特分校、斯坦福大学
- 工作单位
- 阿尔伯塔大学
研究领域
师承
博士导师1
博士生2
来自 Wikidata 的「博士导师」「师从」「博士生」「学生」记录,可能不全。
所获奖项(4)
- 2001人工智能促进协会会士
- 2018Lifetime Achievement Award of the Canadian Artificial Intelligence Association
- 2021英国皇家学会院士
- 2024图灵奖
学会与院士
百科正文
2024年,他与安德鲁·巴托共同获得图灵奖。
早年生活与教育
理查德·萨顿出生于1957年或1958年, 俄亥俄州托莱多,,并在美国伊利诺伊州芝加哥郊区的奥克布鲁克长大。
萨顿于1978年自斯坦福大学获取心理学文学士(BA)学位,随后在安德鲁·巴尔托(Andrew Barto)的指导下,于马萨诸塞大学阿默斯特分校获取计算机科学理学硕士(1980年)及博士(1984年)学位。他的博士论文 提出了“行为者-评论者”(actor-critic)架构与时序信用分配(temporal credit assignment)概念。
他深受哈里·克洛普夫(Harry Klopf)于1970年代的研究影响,该研究提出监督式学习不足以解释人工智能或智能行为,而由“行为的享乐层面”驱动的试错学习是必要的。这使他将研究兴趣转向强化学习。
研究成果
萨顿(Sutton)与巴尔特(Barth)以马可夫决策过程(MDP)为数学基础,建构了一套框架,使代理人在随机环境下能学习如何采取行动以最大化奖励。传统的MDP理论假设代理人完全了解环境模型,而萨顿等人提出的强化学习之所以具有划时代意义,在于其即使在环境与奖励皆未知的情况下仍能适用。
主要学术贡献如下。
时序差分学习(TD学习)——于1988年论文《Learning to predict by the methods of temporal differences》中提出的、无需模型且能逐次学习价值函数的一系列算法。
Dyna架构——集成学习、规划与行动的框架(1991年)。
选项框架 — 强化学习中用于时间抽象化的数学框架(1999年,与多伊娜·普雷祖普(英文版)、萨廷德·辛(Satinder Singh Baveja)合著)。
带函数近似的策略梯度法 — 阐述了现代策略梯度定理(2000年)。
在2019年发表的文章《苦涩的教训》(The Bitter Lesson)中,他主张“将人类思考方式纳入的作法长期来看行不通,唯有善用运算资源的通用方法才能最终胜出”,此论点引发了关于人工智能研究方向的广泛讨论。在文章中,萨顿批评人工智能研究领域未能领悟到“将我们自认为的思考方式建模,从长远来看是行不通的”,并主张“70年来的人工智能研究[已证明],运用运算的通用方法最终是最有效的,且优势极为显著”,其成效远胜于基于人类在电脑视觉、语音识别、国际象棋或围棋等特定领域知识所进行的研究。
近年来,他对大型语言模型(LLM)持批判立场,并论述指出:LLM仅是需要独立训练阶段的模仿学习,而我们需要的是能透过与环境持续交互来学习的“经验时代(Era of Experience)”架构。
奖项与荣誉
萨顿自 2001 年起即为人工智能促进协会(AAAI)的院士; 其提名理由如下:“因对机器学习的许多领域,包括强化学习、时序差异技术及神经网络,作出重大贡献。” 2003年,他获得国际神经网络学会颁发的“会长奖”;2013年,则获马萨诸塞大学阿默斯特分校颁发“杰出研究成就奖”。 他与安德鲁·巴尔托共同获得计算机协会(ACM)颁发的2024年图灵奖;该奖项的授奖辞写道:“因建立强化学习的概念与算法基础。”
2016年,萨顿当选为加拿大皇家学会院士。 2021年,他当选为伦敦皇家学会(FRS)院士。
个人生活
萨顿于2015年获取加拿大国籍, 并于2017年传出他已放弃美国国籍的消息。
以上内容摘自维基百科「理查德·S·薩頓」,按 CC BY-SA 4.0 使用,去掉了参考文献、外部链接等尾部小节,公式改写成了纯文本。全文、配图和出处见原文。
同一学科、同时代的科学家





同一学科的科学家
更多 ›