格物
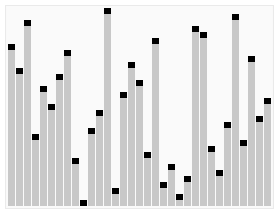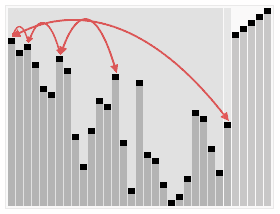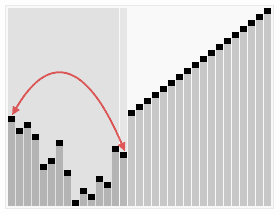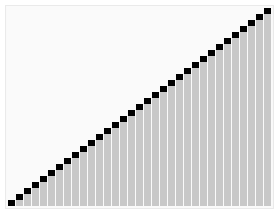
图:de:User:RolandH · CC BY-SA 3.0 · Wikimedia Commons
- 类型
- 排序算法、比较排序
- 发现 / 发明时间
- 1964 年
- 发现者 / 提出者
- J. W. J. Williams
- 用到了
- 数组
百科正文
概述
若以升序排序说明,把数组转换成最大堆(Max-Heap Heap),这是一种满足最大堆性质(Max-Heap Property)的二叉树:对于除了根之外的每个节点i, A[parent(i)] ≥ A[i]。
重复从最大堆取出数值最大的结点(把根结点和最后一个结点交换,把交换后的最后一个结点移出堆),并让残余的堆维持最大堆性质。
堆节点的访问
- 通常堆是通过一维数组来实现的。在数组起始位置为0的情形中:
- 父节点i的左子节点在位置 (2i+1);
- 父节点i的右子节点在位置 (2i+2); (公式略)
- 子节点i的父节点在位置 (公式略);
堆的操作
在堆的数据结构中,堆中的最大值总是位于根节点(在优先队列中使用堆的话堆中的最小值位于根节点)。堆中定义以下几种操作:
最大堆调整(Max Heapify):将堆的末端子节点作调整,使得子节点永远小于父节点
建立最大堆(Build Max Heap):将堆中的所有数据重新排序
堆排序(HeapSort):移除位在第一个数据的根节点,并做最大堆调整的递归运算
实现示例
原地堆排序
基于以上堆相关的操作,我们可以很容易的定义堆排序。例如,假设我们已经读入一系列数据并创建了一个堆,一个最直观的算法就是反复的调用del_max函数,因为该函数总是能够返回堆中最大的值,然后把它从堆中删除,从而对这一系列返回值的输出就得到了该序列的降序排列。真正的原地堆排序使用了另外一个小技巧。堆排序的过程是:
建立一个堆 H[0..n-1]
把堆首(最大值)和堆尾互换
把堆的尺寸缩小1,并调用shift_down(0),目的是把新的数组顶端数据调整到相应位置
重复步骤2,直到堆的尺寸为1
平均复杂度
堆排序的平均时间复杂度为 O (nlog n),空间复杂度为 Θ (1)。
以上内容摘自维基百科「堆排序」,按 CC BY-SA 4.0 使用,去掉了参考文献、外部链接等尾部小节,公式改写成了纯文本。全文、配图和出处见原文。